
 搜索
 数字报
 深圳号
 投诉举报
 深圳特区报&读特记者 闻坤
随着AI集群规模不断扩大,算力芯片之间的数据交换量快速增长,业界正在以Scale-up的方式将成百上千颗算力芯片纳入同一个高带宽、低延迟、紧耦合的“超节点”全新互连单元;当超节点从单机柜级跃迁到多机柜,传统的电互连正在逼近带宽密度、互连时延和传输能耗的物理极限,光互连成为必然选择。
对国产算力芯片而言,这是一个关键的产业机遇期——以片间光互连和OIO高效聚合多芯片算力,是国产算力体系突破单体性能天花板、支撑超大规模AI集群的现实路径。

NPO光互连集成模块
近日,澜昆微电子携WDM微环光I/O芯片、线性直驱CPO芯片及光互连交换卡/计算卡等创新成果亮相IICIE国际集成电路创新博览会。
扎根深圳:深耕大湾区光电融合产业腹地
澜昆微成立于2024年,总部位于上海,已形成北京、上海、深圳三地布局,其中深圳研发基地是公司贴近大湾区算力产业腹地、加速光互连产品工程化落地的关键一环。
大湾区聚集了国内领先的GPU/AI算力芯片设计企业、交换芯片企业以及算力整机与云服务厂商,是光互连方案需求最集中、芯片级协同设计机会最丰富的区域。深圳研发基地让澜昆微得以与客户在联合设计、快速验证上紧密配合,大幅缩短从需求到方案的迭代周期。

线性直驱微环光电合封
同时,深圳及珠三角拥有国内最完善的光器件、光模块、精密制造与先进封测配套体系,从芯片到板卡、从样品到量产的工程化链条高度成熟,为光互连产品的快速落地提供了理想的产业环境。
此外,深圳“20+8”产业集群规划将半导体与集成电路列为重点发展方向,为光电融合企业提供了系统性的发展环境。
微环光I/O,撑起下一代Scale-Up超节点的关键
在硅光调制器的技术路线上,MZM是过去十年光通信领域的主流方案,但其尺寸大、能耗高、不天然支持波分复用的局限日益凸显,难以满足OIO进入芯片封装的面积与功耗预算。
微环路线则从根本上改变了这一格局。它的核心结构是一个直径仅数微米的环形谐振腔。当光在环内传播时,满足谐振条件的特定波长会被“困”在环中产生共振增强;通过电信号改变环内材料的折射率,就能以极低的能耗快速开关或调制这束光。
2026年3月,英伟达、博通、AMD、Meta、微软、OpenAI六家公司联合宣布成立OCI MSA组织,基于微环调制器的波分复用多路并行技术方案,建立了开放、可互操作的AI Scale-up光互连规范,标志着微环调制器已经成为国际主流技术路线。
率先推出适配OCI国际标准的光电融合微环OIO芯片
澜昆微是为数不多具备“芯片设计—硅光器件—高速电芯片(Driver/TIA)—光电封装”芯片级全栈自研能力的稀缺团队,在国内率先推出适配OCI国际标准的光电融合微环OIO芯片,将微米尺寸的微环调制器和光电融合集成,可在单根光纤下实现8个波长的复用,单芯片3.2Tb/s的超高带宽和1Tbps/mm的互连密度。相较于传统光模块,可实现带宽和集成度的10倍上升,能耗和成本的10倍降低。

单片集成的微环光I/O
微环光I/O高度依赖大尺寸晶圆硅光与CMOS电路融合集成的工艺能力,全球具备这一制造能力的晶圆厂仅有少数几家。澜昆微发布的微环I/O芯片Denali,基于国际头部Foundry实现,其光电协同设计能力直接落在经全球一线客户验证过的可靠工艺基座之上。
目前,澜昆微围绕算力互连(Scale-up)赛道,已形成OIO、CPO、NPO三大产品线,覆盖交换芯片到计算芯片的不同集成层次。
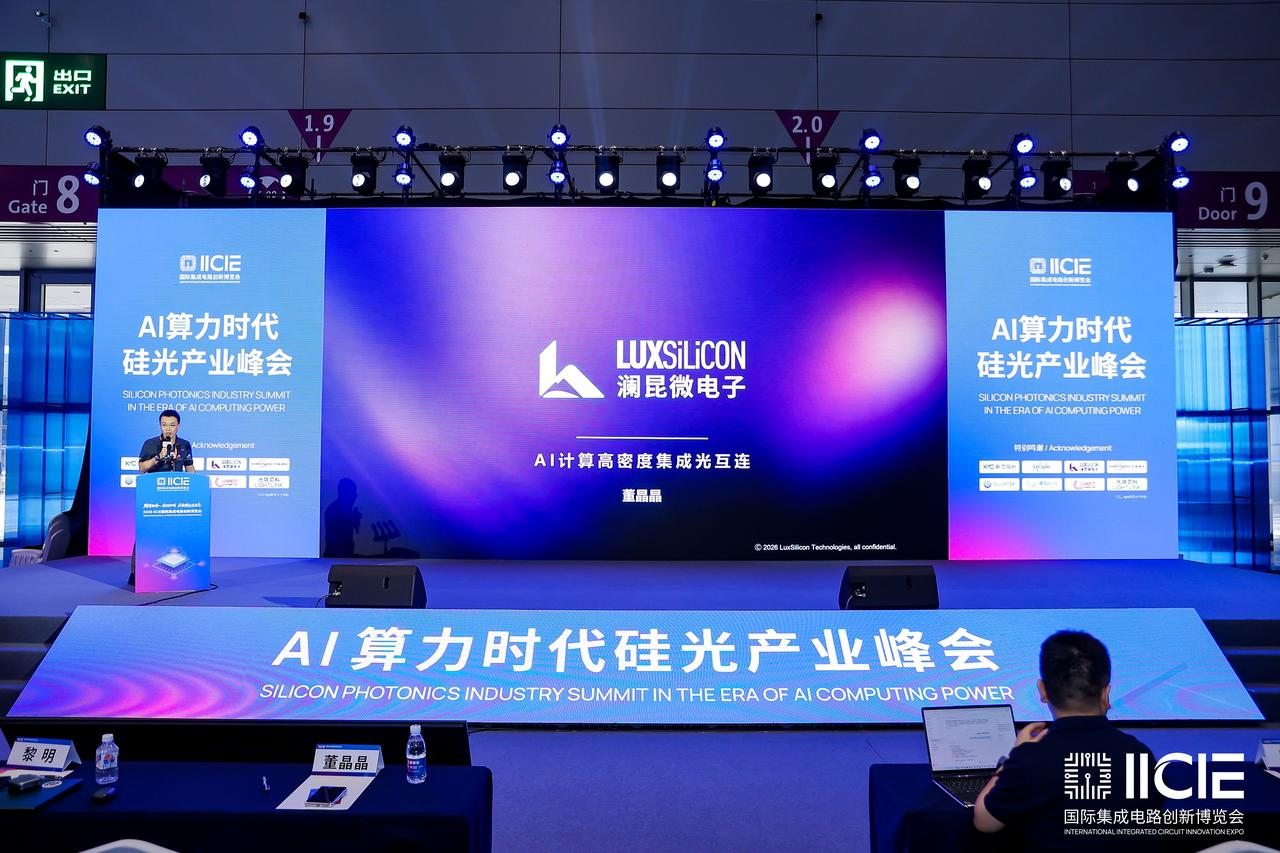
本次展会上,国内首个符合OCI MSA标准的微环光I/O芯片Denali首次公开亮相,澜昆微正式披露与国际头部企业GlobalFoundries的深度合作,并公开与Luceda Photonics的设计闭环合作。9月10日,澜昆微CEO董晶晶出席“AI算力时代硅光产业峰会”并发表主题演讲《AI计算高密度集成光互连》。
展望未来,随着AI算力集群规模持续扩大、OCI标准生态逐步成熟,计算光互连有望成为光互连领域增速最快、空间最大的细分市场。LightCounting报告显示,2025年光收发器和CPO市场规模已达165亿美元,2026年将激增至260亿美元;YOLE预测,到2030年OIO for Scale-Up市场规模将达到55亿美元。率先跑通“设计—流片—验证”全流程的企业,将在这一轮产业化进程中占据先发位置。
(受访单位供图)
编辑 刘彦 审核 程刚明 李怡天
 报料
 读特热榜
 IN视频


 鹏友圈


 iPhone客户端
 安卓客户端

